Hermes /learn 实战:如何把一次复杂任务沉淀成真正可复用的 Skill
核心观点:
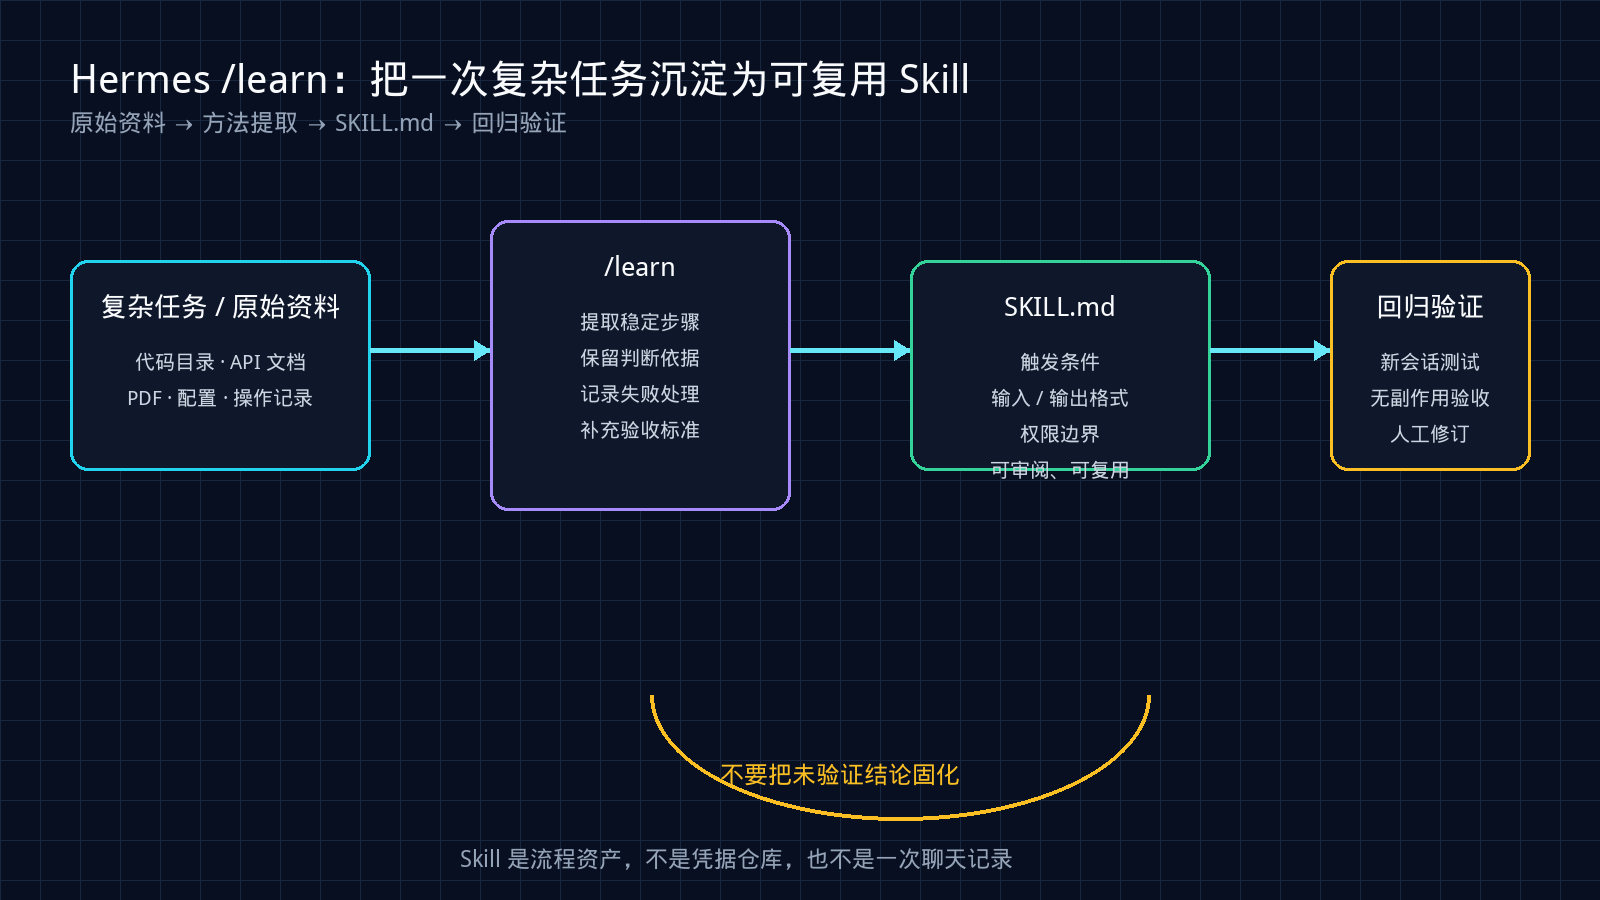
/learn的价值不是让 Hermes“自动记住一切”,而是把一次任务中的步骤、判断依据、失败处理和验收标准,整理成下一次可以复用和检查的SKILL.md。
这个主题为什么值得做成长期内容
在已有 Hermes X 日报采集记录中,官方曾介绍 /learn:可以从代码、API 文档、手册、PDF、配置等资料中提炼可验证、可复用的 Skill;社区也把它称为完成复杂工作流后值得使用的命令。
来源:@NousResearch、@iamlukethedev。
这类主题比单纯的版本新闻更适合运营,因为读者真正想知道的是:什么时候用、输入什么、生成后怎么检查、怎样避免把错误经验永久化。
先理解:Skill 不是聊天记录
一份合格的 Skill 至少应该回答五个问题:
- 触发条件: 什么任务适合使用它?
- 前置条件: 需要哪些工具、权限、环境变量或输入文件?
- 执行步骤: 应按什么顺序完成?
- 失败处理: 失败时如何诊断、重试或回滚?
- 验收标准: 什么结果才算真正完成?
如果只有“先运行命令 A,再运行命令 B”,那更像个人备忘录,而不是可复用 Skill。
什么时候应该使用 /learn
适合的场景
- 你刚完成一次复杂部署,下一次还会重复;
- 你解决了一个需要多轮排查的故障;
- 你研究完一套 API,需要以后持续调用;
- 你把一份手册、规范或代码库整理成工作方法;
- 你建立了一套内容采集、校验和发布流程。
不适合直接固化的场景
- 只成功过一次、且原因还不确定;
- 依赖临时网页、短期版本或一次性凭据;
- 里面混有 API Key、Cookie、Token、私钥或个人数据;
- 结果没有验收,只是“看起来应该可以”;
- 任务高度依赖个人偏好,尚未抽象出稳定边界。
一套稳妥的 /learn 工作流
第一步:保存任务上下文,但先去除敏感信息
在让 Hermes 学习之前,整理出:
任务目标:要解决什么问题
环境:操作系统、软件版本、运行位置
输入:使用了哪些文件、参数和资料
关键步骤:哪些操作真正改变了结果
失败点:哪里失败,错误表现是什么
验收:用什么命令或现象证明成功
凭据不要放进学习材料。示例中使用 [REDACTED] 或环境变量名即可,不要把真实值写入 Skill。
第二步:让 /learn 关注“方法”,不要只总结“结果”
提示词可以这样写:
请把刚才完成的任务整理成一个可复用 Skill。

要求:
1. 只保留可重复的步骤和判断依据;
2. 明确前置条件、依赖命令和权限边界;
3. 把失败情况和诊断方法单独列出;
4. 为每一步添加可执行的验收标准;
5. 删除所有密码、Token、Cookie、私钥和个人数据;
6. 对没有实际验证的内容标记为“待验证”,不要写成已确认事实;
7. 输出 SKILL.md 草稿,不要直接修改生产配置。
第三步:人工审阅生成的 Skill
重点检查四类问题:
| 检查项 | 常见错误 | 修正方式 |
|---|---|---|
| 版本 | 把一次性的命令写成永久规则 | 加版本和日期,说明适用范围 |
| 权限 | 默认开放删除、发送、部署能力 | 改成最小权限,危险操作人工确认 |
| 结论 | 把推测写成实测结果 | 增加证据或改为待验证 |
| 失败处理 | 只写成功路径 | 增加错误分类、日志位置和回滚步骤 |
示例:把一次内容运营任务变成 Skill
假设你完成了一次“从 X 发现 Hermes 热点、交叉核验、写文章、配图、发布”的任务。不要把 Skill 写成“每天找热点并发布”,而应拆成可检查的流程:
---
name: hermes-topic-to-article
description: 从 Hermes 官方与社区公开动态提炼可核验选题,并生成结构化中文文章
---

# 触发条件
当需要把 Hermes 相关公开动态扩展为原创实用文章时使用。

# 来源优先级
1. 官方公告、官方文档、项目仓库
2. 维护者原帖
3. 可定位到原帖的社区案例

# 必须输出
- 选题判断
- 原始 URL、作者和日期
- 官方说法与社区说法的区分
- 面向读者的实际步骤
- 限制、风险和待核验项
- 文章结构与配图说明

# 禁止事项
- 不把社区展示写成官方保证
- 不编造性能数字、用户数量或实测日志
- 不输出凭据、Cookie、Token 或登录状态内容
- 不在没有人工确认时自动发布外部内容

# 完成标准
每个关键事实有来源;每个操作步骤有前置条件和验收方式;
文章经过链接检查、敏感信息扫描和人工发布确认。
Skill 生成后如何验证
不要因为文件生成成功,就认为 Skill 可用。至少做一次“冷启动回归”:
- 开一个新的 Hermes 会话;
- 只提供触发条件和最小输入;
- 检查它是否正确加载 Skill;
- 按 Skill 的步骤执行一个无副作用测试;
- 对照完成标准逐项验收;
- 记录版本、日期、失败点和修改原因。
如果 Skill 涉及浏览器、X、邮箱、GitHub、部署或删除操作,先使用只读模式,确认结果后再开放写权限。
常见误区
误区一:把越长当成越好
Skill 过长会增加上下文负担,也可能让关键步骤被淹没。把稳定主流程留在 SKILL.md,把详细 API 说明、长日志和示例放到 references/。
误区二:把模型的补全当成实测
/learn 可以整理材料,但不能替你证明材料中的每个结论。命令是否存在、权限是否足够、版本是否兼容,都需要实际回归。
误区三:把记忆、Skill 和凭据混在一起
Skill 是公开或可审阅的流程;记忆是上下文信息;凭据应由安全存储管理。三者不要写进同一个文件。
误区四:学习一次,就永久不维护
软件版本、网页结构和 API 都会变化。给 Skill 加上适用版本和“最后验证日期”,遇到错误时及时修订,而不是继续叠加补丁。
最小验收清单
- [ ] Skill 有明确触发条件;
- [ ] 前置依赖和权限写清楚;
- [ ] 步骤按可重复顺序排列;
- [ ] 失败处理不是一句“重试”;
- [ ] 每个关键结果都有验收标准;
- [ ] 未验证内容已明确标注;
- [ ] 没有真实凭据和私人数据;
- [ ] 新会话中完成过一次无副作用回归;
- [ ] 记录了适用版本和最后验证日期。
结语
/learn 最适合用在“已经完成、值得重复、能够验收”的任务上。高质量的 Skill 不会让 Hermes 变得神秘,反而会让流程更透明:别人能读懂,你能复核,版本变化时也知道哪里需要更新。
对内容运营而言,这种能力可以把一次热点响应沉淀为长期资产:下一次出现类似主题时,不必从零开始,而是沿用经过检查的选题、核验、写作和发布流程。
来源与更新时间
- 主题来源:Hermes 官方与社区公开 X 帖文,链接已列于正文。
- 本文定位:方法论与操作模板,未声称对
/learn在所有版本中的具体行为完成独立实测。 - 更新日期:2026-08-27